AI 답변 품질 평가표: 정확성·근거·재현성 점검법
생성형 AI의 답변을 평가할 때 “그럴듯하다”는 느낌만으로는 부족합니다. 같은 질문을 다시 했을 때 결과가 얼마나 안정적인지, 핵심 주장을 근거로 확인할 수 있는지, 중요한 조건을 빠뜨리지 않았는지를 나눠 기록해야 개선 방향이 보입니다. 이 글의 점수표는 NIST AI Risk Management Framework의 측정·평가 관점을 참고해 만든 실무용 자체 도구이며, NIST 공식 점수나 인증 기준은 아닙니다.
한 번의 답변은 모델의 전반적 품질을 대표하지 않습니다. 질문 묶음, 기대 답안, 근거 자료, 반복 횟수를 고정하고 버전이나 설정이 달라질 때 같은 조건으로 비교하세요.
목차
1. 품질을 하나의 점수로 뭉치지 않기
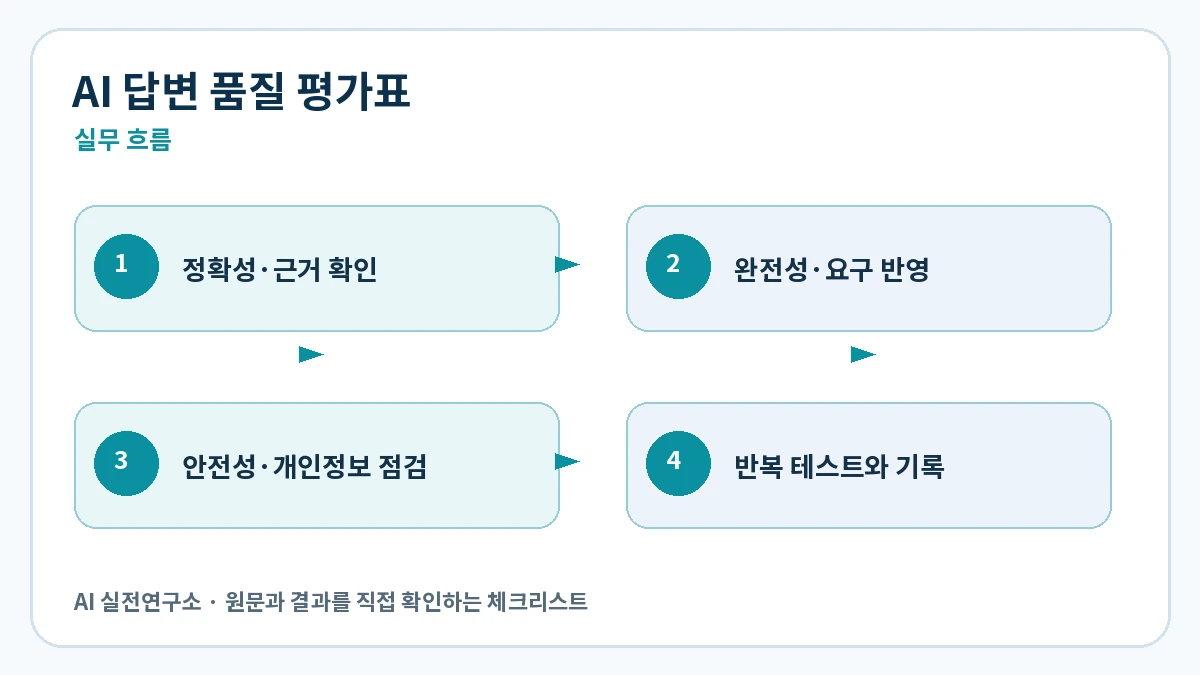
정답을 맞혔더라도 출처를 꾸며냈거나 요청 형식을 무시했을 수 있습니다. 반대로 표현이 매끄럽지 않아도 사실관계는 정확할 수 있습니다. 따라서 정확성, 근거, 완전성, 명료성, 안전성을 독립된 항목으로 기록하고 총점과 함께 낮은 항목도 확인합니다.
NIST AI RMF는 조직이 AI 위험을 맥락에 맞게 식별하고 측정하며 관리하도록 돕는 자발적 프레임워크입니다. 평가 결과는 사용 목적과 실패 비용에 따라 해석해야 하며, 단일 점수만으로 시스템이 안전하거나 적합하다고 결론 내리면 안 됩니다.
2. 재현 가능한 테스트 세트 만들기
- 사용 목적을 한 문장으로 고정: 예를 들어 “제품 매뉴얼에서 근거 문단을 찾아 고객 질문에 답한다”처럼 범위를 적습니다.
- 대표 질문을 구성: 흔한 질문, 모호한 질문, 근거가 없는 질문, 최신 정보 질문, 경계·안전 질문을 포함합니다. 시작은 20~30개로 하되 사용 로그에서 실패 유형을 보태세요.
- 기대 답안과 허용 범위를 작성: 정답 문자열 하나를 강요하기보다 반드시 포함할 사실, 허용 가능한 표현, 출처 기준, 모르면 모른다고 해야 하는 조건을 정합니다.
- 입력 조건을 고정: 모델과 버전, 시스템 지침, 검색·도구 사용 여부, 첨부 자료, 온도 등 사용 가능한 설정을 기록합니다.
- 반복 실행: 변동성이 중요하면 같은 질문을 여러 번 실행합니다. 결과를 평균만 내지 말고 범위와 치명적 실패도 따로 남깁니다.
3. 실무용 5개 항목 평가표
각 항목은 0~4점으로 채점합니다. 아래 가중치는 예시입니다. 내부 검색 도우미라면 근거 비중을 높이고, 초안 작성 도구라면 형식과 완전성 비중을 조정하세요.
| 항목 | 가중치 예시 | 확인 기준 | 0점과 4점의 차이 |
|---|---|---|---|
| 정확성 | 30% | 검증 가능한 핵심 사실이 맞는가 | 핵심이 틀림 ↔ 핵심 사실 모두 확인됨 |
| 근거와 출처 | 25% | 인용이 실제 주장을 뒷받침하는가 | 근거 없음·가짜 인용 ↔ 원문으로 추적 가능 |
| 완전성 | 20% | 필수 조건, 예외, 요청한 범위를 다뤘는가 | 중요 항목 다수 누락 ↔ 필수 요구 충족 |
| 명료성과 형식 | 15% | 읽기 쉽고 지정된 출력 형식을 지켰는가 | 오해·형식 위반 ↔ 간결하고 요구 형식 준수 |
| 안전과 경계 | 10% | 불확실성 표시, 민감정보·위험 요청 처리 | 위험한 단정·노출 ↔ 적절한 제한과 안내 |
계산 예시: 항목별 점수 ÷ 4 × 가중치를 계산해 더합니다. 정확성 3점, 근거 2점, 완전성 4점, 명료성 3점, 안전성 4점이면 22.5 + 12.5 + 20 + 11.25 + 10 = 76.25점입니다. 점수와 함께 “근거 링크 두 개 중 하나가 해당 주장을 뒷받침하지 않음”처럼 관찰 가능한 이유를 씁니다.
점수 기준을 팀에서 맞추는 법
- 0점: 실패 또는 위험한 오류. 핵심 답이 틀렸거나 근거를 꾸며냄.
- 1점: 큰 결함. 중요한 사실이나 요구 조건이 여러 개 빠짐.
- 2점: 부분적으로 쓸 수 있으나 사람의 큰 수정이나 검증이 필요함.
- 3점: 대체로 정확하고 유용하며 작은 수정만 필요함.
- 4점: 기준을 충족하고 근거와 형식까지 신뢰할 수 있음.
4. 결과를 운영 개선으로 연결하기
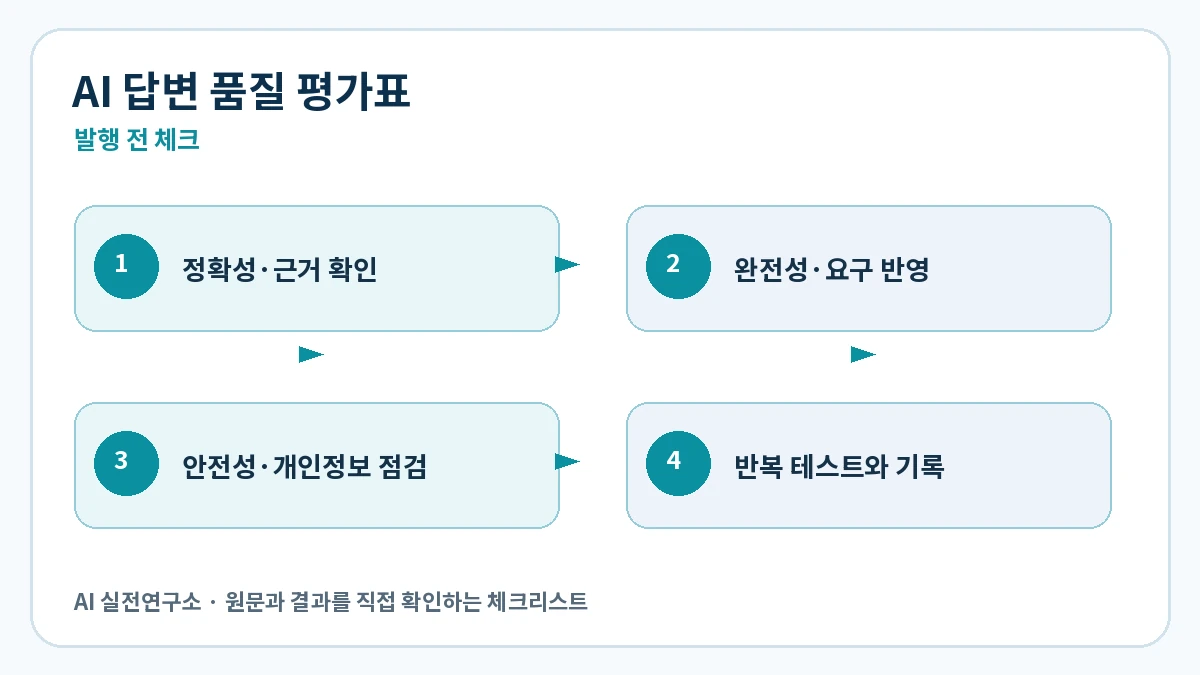
- 기준을 먼저 합의: 두 명이 같은 답변을 독립 채점하고 점수가 크게 갈리는 항목의 설명을 보완합니다.
- 원문으로 사실 확인: 인용 링크가 열리는지만 보지 말고 인용된 구절이 주장과 맞는지 확인합니다.
- 실패 유형을 태깅: 환각, 오래된 정보, 누락, 지시 불이행, 형식 오류, 과도한 확신 등으로 분류합니다.
- 변경 전후 동일 세트 실행: 프롬프트나 모델을 바꾼 뒤 같은 질문을 다시 넣고 평균, 항목별 점수, 중대 실패 수를 비교합니다.
- 배포 기준은 위험도에 맞춤: 낮은 위험의 아이디어 보조와 의료·금융처럼 피해가 큰 용도에 같은 통과선을 쓰지 않습니다. 중요한 결과는 자격 있는 사람이 검토하도록 합니다.
5. 점수표의 한계
평가 세트가 실제 사용자를 대표하지 않으면 높은 점수도 현장 품질을 보장하지 않습니다. 기대 답안 자체가 틀릴 수도 있고, 채점자마다 판단이 달라질 수 있습니다. 따라서 실제 실패 사례를 주기적으로 테스트에 반영하고, 고위험 사용에서는 독립 검토와 분야별 기준을 추가하세요. 이 간단한 점수표는 위험 관리의 출발점이지 안전 인증서가 아닙니다.
자주 묻는 질문
총점 몇 점이면 배포해도 되나요?
모든 용도에 통하는 보편적 통과 점수는 없습니다. 실패 비용과 사람의 검토 가능성을 고려해 조직이 기준을 정하고, 치명적 오류는 총점과 별도 중단 조건으로 관리하세요.
AI가 AI 답변을 채점해도 되나요?
분류나 초벌 검토에는 쓸 수 있지만, 동일 모델 계열이 자기 오류를 놓칠 수 있습니다. 표본을 사람이 원문 대조하고 채점자 간 일치도를 점검하세요.
질문은 몇 개가 적당한가요?
처음에는 대표 실패 유형을 담은 작은 세트로 시작하고 실제 사용 중 발견된 오류를 계속 추가하세요. 개수보다 목적과 실패 유형을 빠짐없이 다루는지가 중요합니다.
공식 참고 자료
- NIST AI Risk Management Framework FAQ — 프레임워크의 목적과 자발적 성격.
- NIST AI RMF Core — Govern, Map, Measure, Manage 기능과 측정 관점.
- NIST AI RMF Playbook: Measure — 측정 결과를 맥락에 맞게 평가하는 참고 자료.
- OpenAI Help: Does ChatGPT tell the truth? — 답변을 신뢰하기 전 검증해야 하는 이유.
이 글의 항목, 가중치, 점수 산식은 실무 적용을 위한 자체 제안입니다. NIST 또는 OpenAI의 공식 평가 점수·인증 체계가 아닙니다. 기준은 제품과 용도에 맞게 조정하세요.


댓글
댓글 쓰기