RAG 검색이 엉뚱할 때: 프롬프트보다 먼저 볼 6단계
RAG(검색 증강 생성)가 엉뚱한 답을 낼 때는 프롬프트를 고치기 전에 검색된 문서가 맞는지, 필요한 근거가 잘리지 않았는지부터 확인해야 합니다. 질문을 고정하고 검색 결과→문맥 구성→생성 순서로 나누면 원인을 좁힐 수 있습니다. 비슷한 출처 검증 과정은 ChatGPT 검색 출처 검증 8단계도 참고하세요.
- 검색 결과가 틀리면 인덱스·청킹·검색어 확장부터 점검
- 문서는 맞지만 답이 틀리면 컨텍스트 조립·지시문·출력검증 점검
- 질문과 기대 근거를 고정한 작은 테스트 세트를 먼저 만듭니다
1. 증상으로 구간 나누기
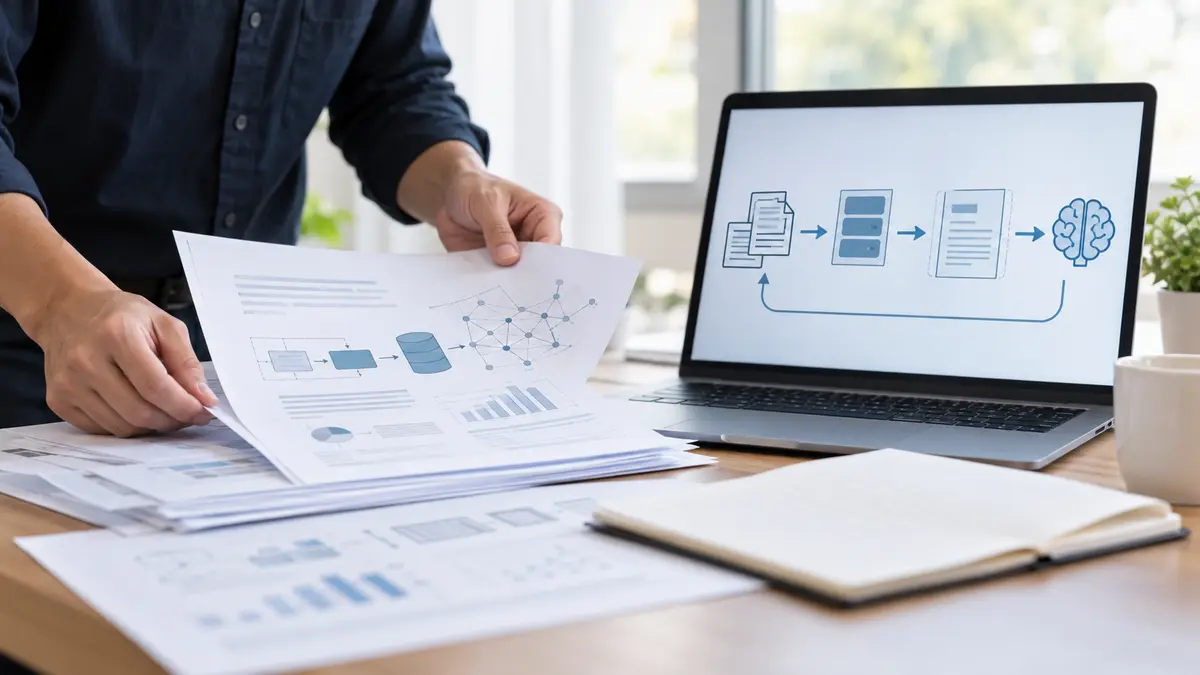
RAG는 보통 문서 수집, 청킹, 임베딩·색인, 검색, 재정렬, 프롬프트에 문맥 삽입, 답변 생성으로 이어집니다. 각 단계의 입력과 출력을 로그로 남기지 않으면 “모델이 틀렸다”만 반복하게 됩니다. 답변에서 근거 문서의 ID와 인용 위치를 함께 보이게 한 뒤, 실제 검색 상위 결과와 대조하세요.
검색 결과 상위에 정답 문서가 없다면 생성 모델은 답을 지어내거나 무관한 자료를 섞을 수 있습니다. 정답 문서는 상위에 있지만 답변에서 빠지면 문맥 길이 제한, 문서 순서, 지시문 충돌 또는 답변 형식 검증 쪽에 무게를 둡니다.
2. 재현 가능한 테스트 만들기
먼저 20~50개 정도의 대표 질문을 준비하고, 각 질문마다 반드시 찾아야 할 문서 ID 또는 핵심 문장을 기대값으로 기록합니다. 이 숫자는 시작용 예시이며 정답 기준은 서비스의 문서 종류와 위험도에 맞춰야 합니다. 테스트 질문에는 흔한 표현, 약어, 띄어쓰기 변형, 답이 문서에 없는 질문을 섞습니다. “문서에 없음” 사례를 빼면 근거가 없는 질문에도 답하는 결함을 발견하기 어렵습니다.
각 실행에서 질문, 검색된 문서 ID·순위·점수, 재정렬 후 순위, 최종 프롬프트에 들어간 발췌문, 답변을 함께 저장합니다. 개인정보나 비밀 문서는 보관 정책과 접근 통제를 먼저 정하고, 테스트에는 가급적 비식별 샘플을 씁니다.
3. 검색과 청킹 조정 순서
첫 검색 결과에 관련 문서가 전혀 없다면 임베딩 모델부터 바꾸지 말고 색인 누락, 문서 파싱 실패, 권한 필터, 언어별 토큰화 문제를 먼저 확인하세요. 특히 PDF 표·제목·각주가 텍스트로 어떻게 추출됐는지 원문과 대조해야 합니다.
문서가 잘렸다면 청크를 무조건 크게 만들기보다 제목·섹션 경계를 보존하고, 청크에 문서 제목과 경로 같은 맥락 메타데이터를 붙입니다. 질문이 여러 개념을 포함하면 키워드 검색과 의미 검색을 함께 쓰거나 재작성한 질의들을 비교할 수 있습니다. OpenAI의 Retrieval 가이드는 벡터 저장소와 검색 결과 조정의 공식 기준을 설명합니다. 관련 자료를 프로젝트별로 다루는 방법은 ChatGPT 프로젝트의 자료·지침 분리 방법과도 연결됩니다.
4. 문맥과 생성 단계 점검
정답 문서가 검색되지만 답이 빗나가면 최종 프롬프트에 그 문서가 실제로 들어갔는지 확인합니다. 토큰 한도에 맞추는 과정에서 중요한 문단이 잘리거나, 중복 청크가 공간을 차지할 수 있습니다. 상위 결과 개수를 늘리는 실험도 무조건 정답률을 높이지 않습니다. 관련 없는 문서가 더 많이 섞이면 모델이 근거를 혼동할 수 있으므로 top-k와 재정렬 기준을 작은 테스트 세트에서 함께 비교해야 합니다.
문서 안의 지시문을 사용자 지시처럼 따르는 문제도 별도 위험입니다. 검색 문서는 신뢰할 수 없는 자료로 취급하고, 답변은 근거가 부족할 때 “자료에서 확인되지 않음”으로 종료하도록 설계하세요. 답변이 문서에 의해 뒷받침되는지 평가할 때는 정답률뿐 아니라 인용 정확성과 무응답의 적절성도 기록합니다.
5. 배포 전 체크리스트
| 관찰 증상 | 먼저 볼 곳 | 다음 실험 |
|---|---|---|
| 관련 문서가 없음 | 수집·파싱·필터·색인 | 원문과 색인 레코드 대조 |
| 관련 문서는 있으나 순위가 낮음 | 질의·청킹·검색 방식 | 키워드/의미 검색과 재정렬 비교 |
| 근거가 프롬프트에 없음 | 문맥 조립·토큰 제한 | 잘림 위치와 중복 제거 확인 |
| 근거가 있는데 답변이 빗나감 | 지시문·인용·검증 | 답변 기준과 무응답 테스트 |
평가 기준은 평균 점수 하나로 끝내지 마세요. 관련 문서가 상위에 잡히는 비율, 답변의 근거 일치, 인용 정확성, 문서에 답이 없을 때의 거절을 따로 추적하면 어떤 변경이 실제 개선인지 알 수 있습니다. OpenAI API로 분석 결과를 검증하는 흐름은 ChatGPT 데이터 분석 결과 검증 방법을 참고해 재현 가능한 표로 남길 수 있습니다.
공식 출처
- OpenAI Retrieval 가이드 — 검색과 벡터 저장소 설정, 확인일 2026-10-27
- AI 실전연구소: 검색 출처 검증
원인을 찾을 때는 검색 결과, 문맥, 생성 순으로 한 구간씩 바꾸고 같은 테스트 질문으로 다시 비교하세요. 한 번에 여러 설정을 바꾸지 않아야 개선 원인을 알 수 있습니다.


댓글
댓글 쓰기